Khám phá thiết kế Super-agent: hướng tới một hệ thống agent tự chủ hơn
Mục lục
- 1. Super-agent
- 2. Kiến trúc hai tầng
- 2.1 Tầng Router
- 2.2 Tầng Worker
- 3. Trigger hướng sự kiện
- 3.1 Lọc sự kiện
- 3.2 Định tuyến sự kiện
- 3.3 Tổ chức context
- 3.4 Làm trước
- 4. Tương tác song công đa kênh
- 4.1 Song công (Full-Duplex)
- 4.2 Đa kênh
- 5. Tách compute, state và môi trường
- 5.1 Tách compute khỏi state
- 5.2 Tách compute khỏi môi trường thực thi
- 6. Watchdog
- 7. Thí nghiệm sơ bộ
- 7.1 Ablation study
- 7.2 Batching ở tầng Router
- 8. Các vấn đề còn mở
- 8.1 Mở rộng kiến trúc hai tầng thế nào
- 8.2 Làm việc với một agent không có session thế nào
- 8.3 Xác định ranh giới context và cộng tác qua A2A thế nào
- 8.4 Đảm bảo bảo mật và quyền riêng tư thế nào
- 9. Kết luận
Bài gốc viết bằng tiếng Trung, DeepSeek Harness đăng bản dịch máy sang tiếng Anh trên X. Bản tiếng Việt này dịch từ bản tiếng Anh đó.
Bài viết bàn về ý tưởng kiến trúc, không giới thiệu các tính năng hiện có của DeepSeek Harness.
1. Super-agent
Trong năm qua, coding agent và các agent làm một việc khác đã cho thấy model có thể dùng tool để giải những bài toán phức tạp, mà con người ngày càng ít phải theo dõi liên tục hay can thiệp từng bước. Model cũng giỏi hơn trong việc điều phối nhiều agent, nên việc tổ chức và lên lịch công việc qua nhiều session đã trở nên khả thi. Khi con người ít tham gia vào phần thực thi cấp thấp, vai trò của họ dần chuyển lên các quyết định cấp cao và khâu duyệt (sign-off).
Model tốt hơn cũng mở ra ứng dụng mới. Gần đây xuất hiện nhiều personal agent. Chúng kết nối thẳng vào tin nhắn, lịch, email và các nền tảng làm việc hằng ngày, theo dõi luồng thông tin và giúp làm việc. Personal agent chỉ là một ứng dụng của cách làm việc luôn trực tuyến, hướng sự kiện (event-driven) này. Cách làm việc đó không chỉ dành cho cá nhân mà còn có giá trị trong công việc thương mại như phát triển phần mềm.
Tuy vậy, các thiết kế agent phổ biến hiện nay khó hỗ trợ cách làm việc này khi có nhiều task hoặc cả một team. Agent vẫn lấy một session làm đơn vị làm việc cơ bản, và các session tách biệt nhau. Người dùng chạy song song nhiều task phải tự chuyển qua lại giữa các session và tự nhớ session nào chứa gì. Theo kinh nghiệm của chúng tôi, một người thường chỉ theo dõi được 3 đến 5 session đang chạy cùng lúc. Với các thiết kế này, một task đơn lẻ bị giới hạn bởi năng lực model, còn làm nhiều việc cùng lúc lại bị giới hạn bởi sự chú ý của con người.
Thêm CLI, MCP hay connector bên ngoài vào một agent local một-session giúp nó nhận được tin nhắn từ bên ngoài, nhưng các giới hạn cơ bản vẫn còn. Nó vẫn chạy trong một session đồng bộ, bị chặn (block) khi gặp thao tác dài; context của các task khác nhau bị trộn lẫn; và mọi thứ dừng lại khi thiết bị local mất kết nối. Giữ cho một setup như vậy chạy được tốn rất nhiều công sức thủ công.
Muốn vượt qua các giới hạn này, phải tách agent khỏi bất kỳ session đơn lẻ nào do con người điều khiển. Thay vào đó, agent nên là một thực thể liên tục, giữ context xuyên suốt các session và làm nhiều task phức tạp cùng lúc mà các task không ảnh hưởng lẫn nhau. Chúng tôi gọi loại agent này cùng kiến trúc hệ thống của nó là Super-agent.
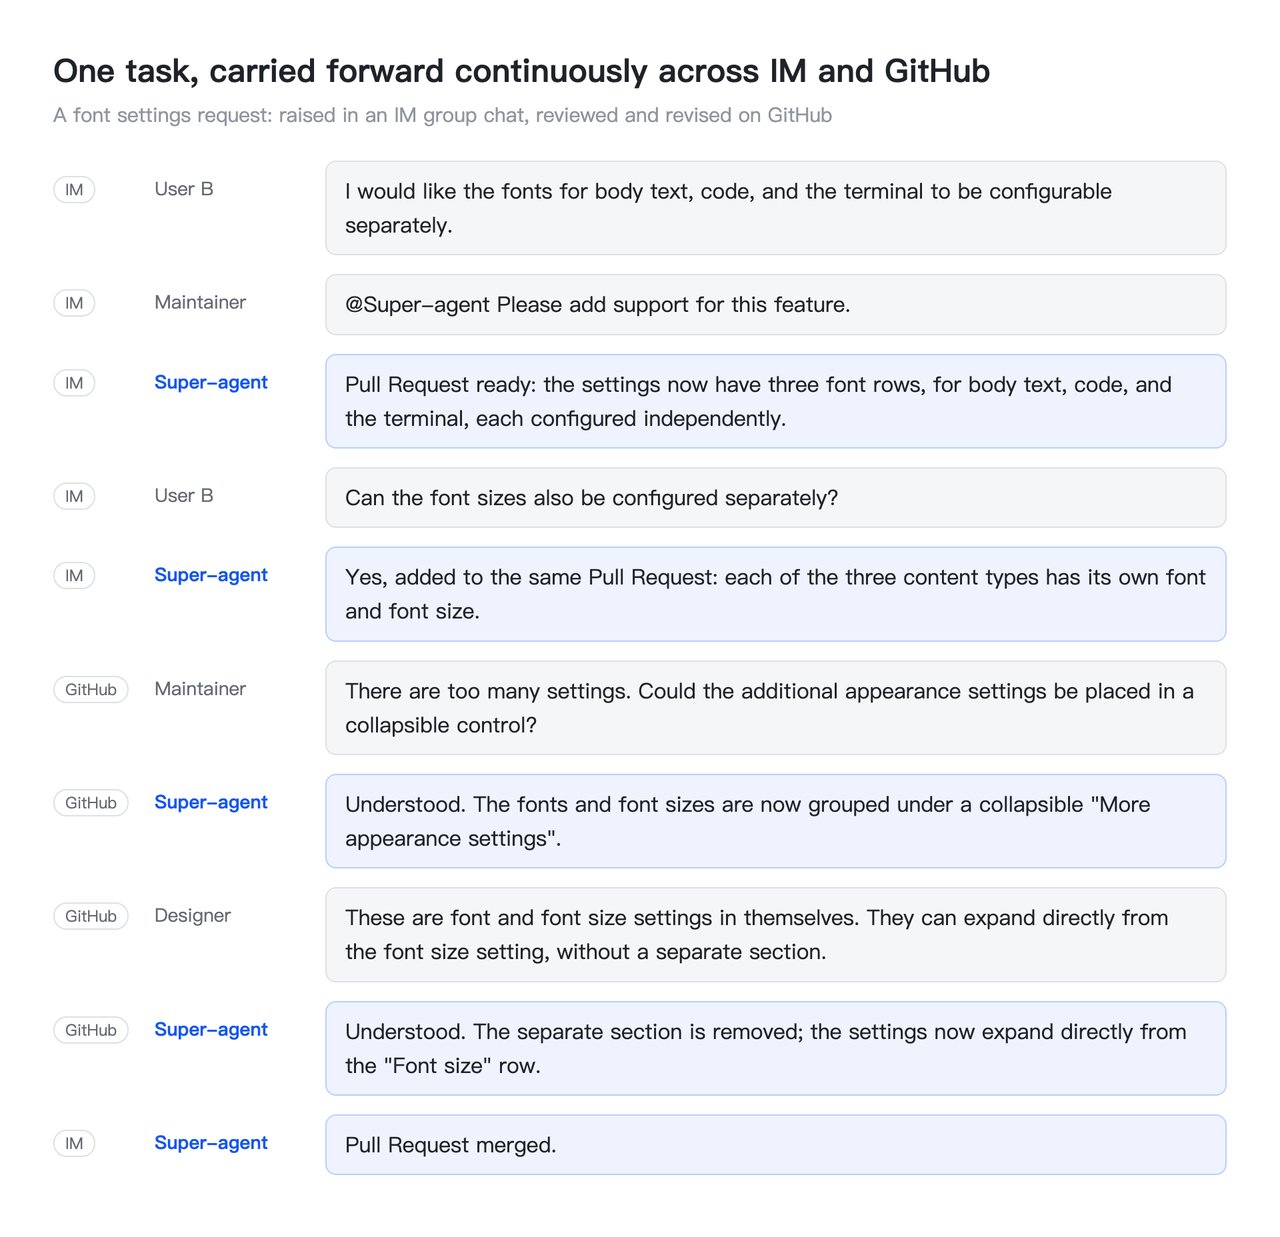
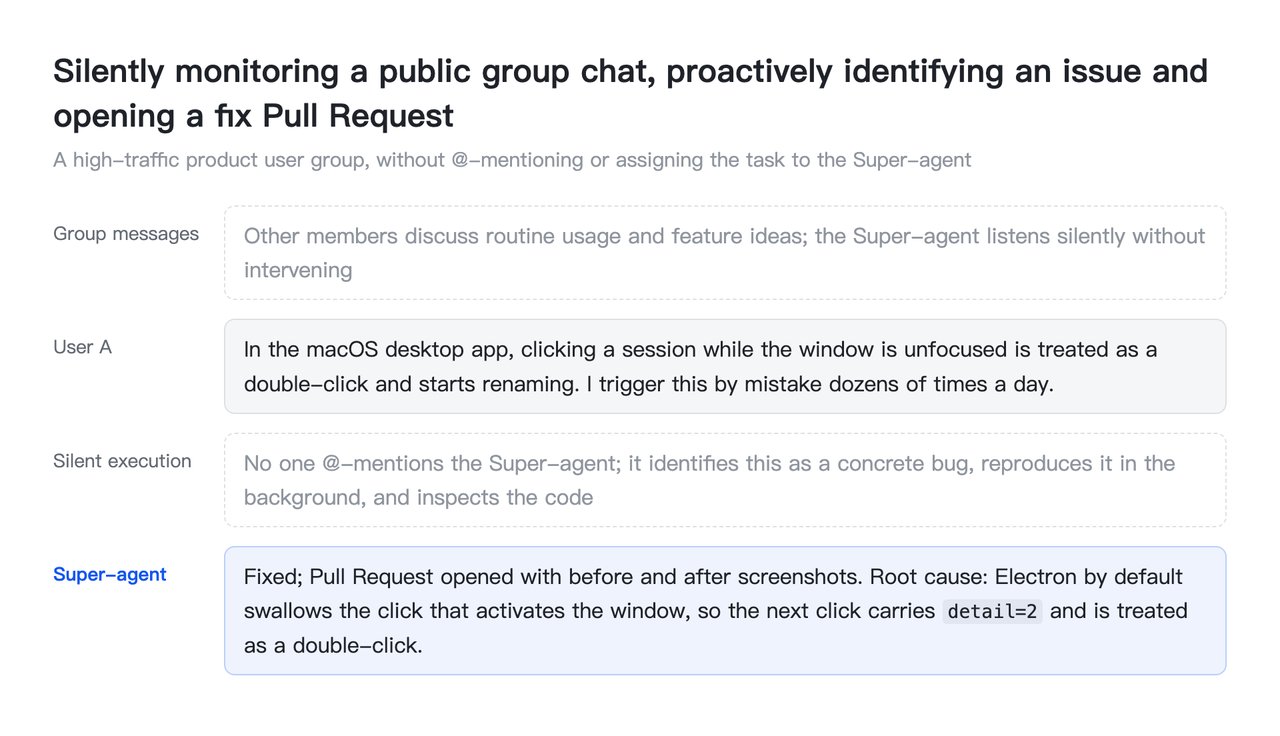
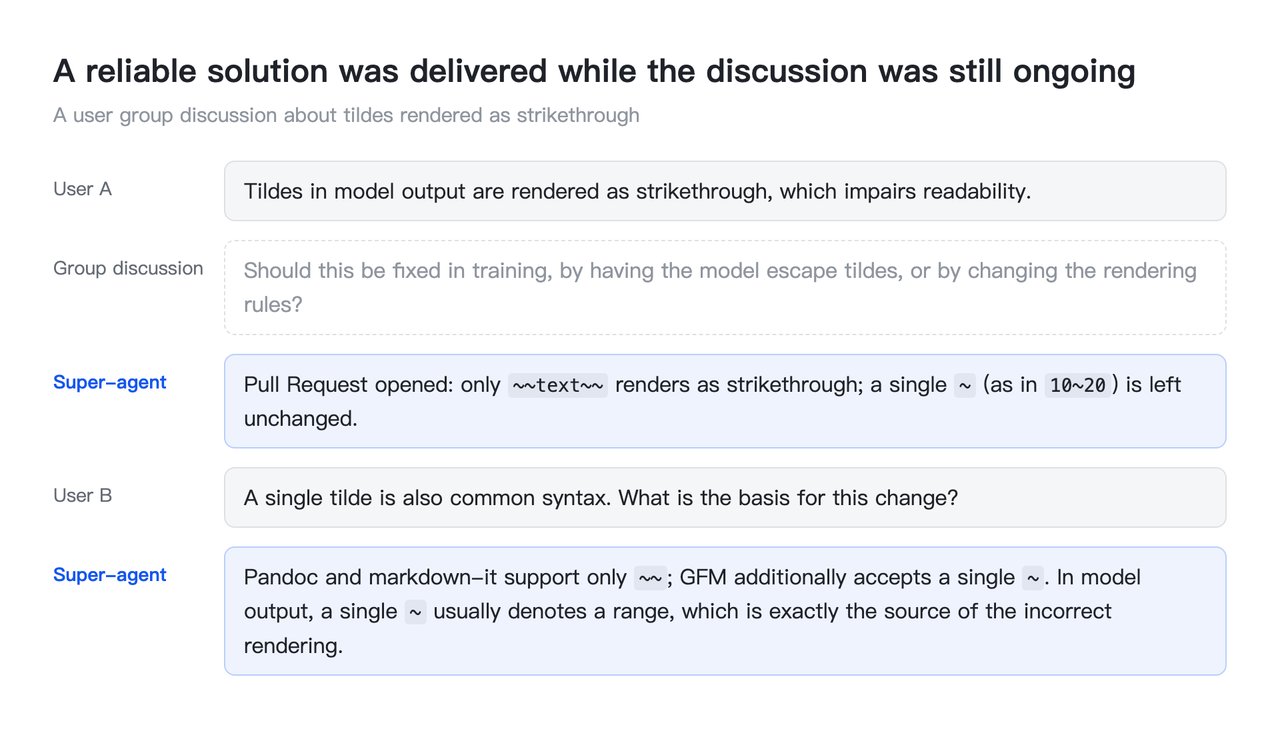
Ví dụ, instance Super-agent nội bộ của chúng tôi, chạy trên DeepSeek Harness, có thể tiếp tục cùng một task phát triển xuyên qua IM và GitHub. Nó cũng theo dõi phản hồi trong các group chat công khai và, kể cả khi không ai @-mention nó, tự tìm ra nguyên nhân gốc và mở Pull Request để sửa:
Chúng tôi cho rằng một Super-agent có bốn đặc điểm cơ bản:
- Liên tục (Continuous): Người dùng tương tác với nó ngay tại nơi họ đang làm việc, như chat IM hay comment trên GitHub, và luôn cảm thấy đang làm việc với một agent duy nhất. Họ không bao giờ phải băn khoăn session X có thông tin Y trong context hay không. Ví dụ, nếu người dùng yêu cầu phương án A trên IM rồi sau đó đổi sang phương án B trong một comment ở Pull Request trên GitHub, agent hiểu sự thay đổi và điều chỉnh việc đang làm.
- Năng suất (Productive): Nó phản hồi nhanh và hoàn thành song song nhiều task phức tạp, task nào cũng đạt chất lượng cao. Nó có thể nhận chỉ dẫn tiếp theo trước khi lệnh hay task trước đó xong.
- Chủ động (Proactive): Nó không chờ chỉ dẫn từng bước. Nó theo dõi các sự kiện trong môi trường, xử lý những gì đáng xử lý, và im lặng trong các trường hợp còn lại.
- Bền bỉ (Persistent): Nó luôn trực tuyến, kết nối thẳng vào môi trường làm việc thật của người dùng, và tự phục hồi khi gặp sự cố trong quá trình chạy dài.
Không một vòng lặp ReAct đơn lẻ nào có thể cùng lúc mang lại cả bốn đặc điểm này, nên chúng phải đến từ kiến trúc hệ thống bao quanh nó. Các ràng buộc thiết kế giống nhau thường dẫn tới các kiến trúc giống nhau. Khi mục tiêu là một hệ thống luôn trực tuyến và phản hồi đồng thời các sự kiện từ môi trường, chúng tôi dự đoán personal agent và agent cho công việc thương mại như phát triển phần mềm sẽ đi tới những thiết kế tương tự. Xây dựng một hệ thống như vậy cũng làm nảy sinh nhiều vấn đề rất giống những vấn đề đã được nghiên cứu lâu năm trong ngành hệ thống máy tính (computer systems), nên nhiều ý tưởng thiết kế kinh điển của ngành đó cũng áp dụng được ở đây.
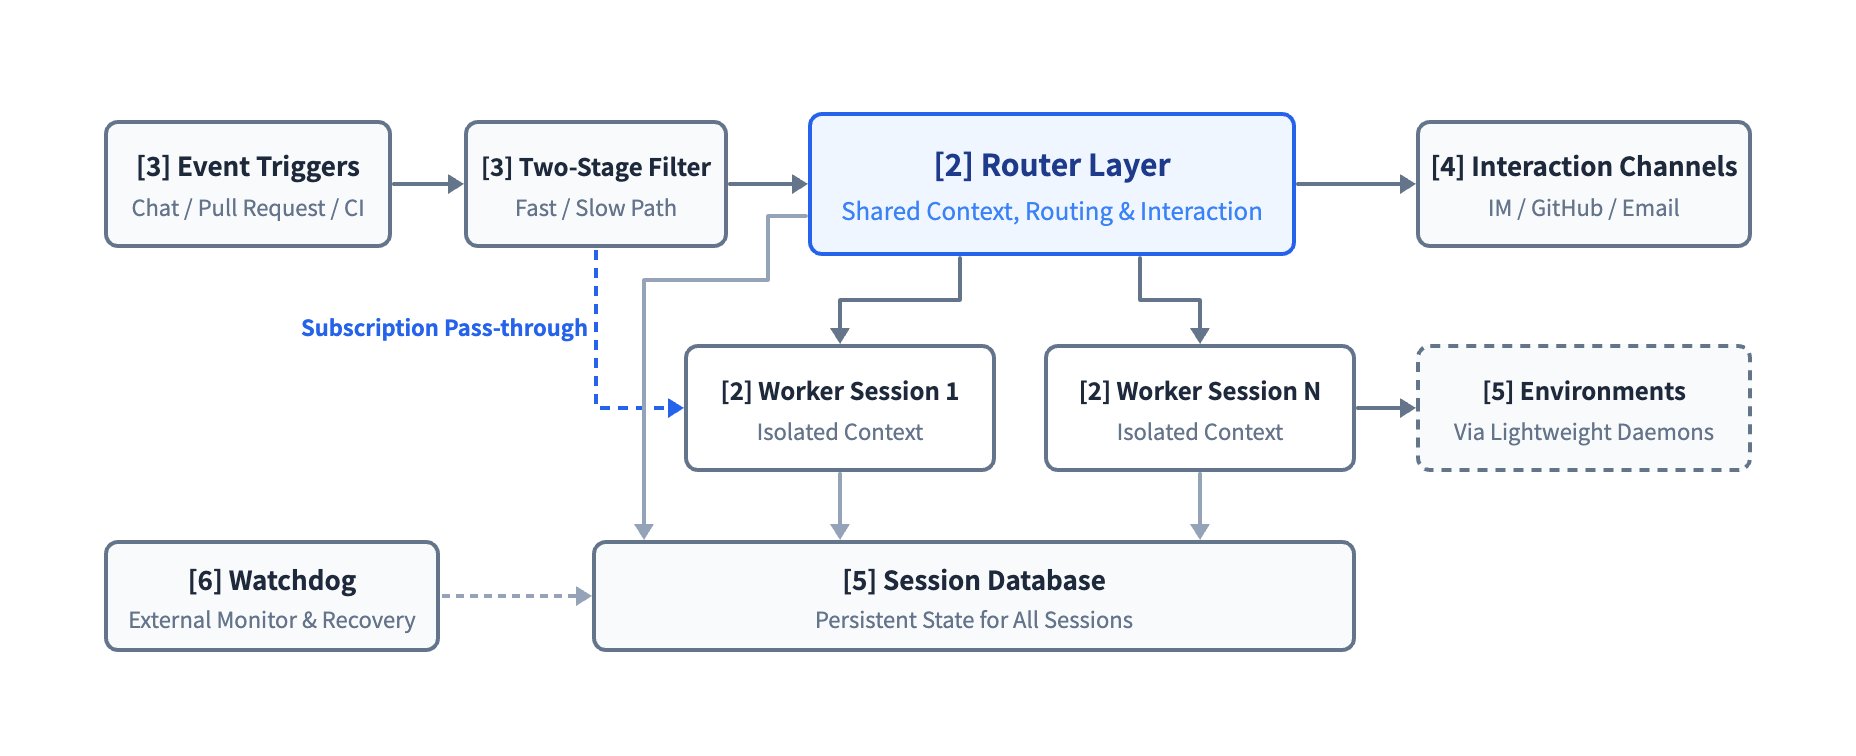
Cách hiện thực sẽ khác nhau, nhưng chúng tôi nghĩ có năm module tạo thành khung cơ bản hỗ trợ các đặc điểm trên. Kiến trúc hai tầng (Phần 2) mang lại cả tương tác liên tục lẫn xử lý đồng thời năng suất. Thiết kế hướng sự kiện (Phần 3) làm cho agent chủ động. Tương tác song công đa kênh (Phần 4) giữ cho mỗi lần trao đổi với người dùng vừa liên tục vừa năng suất. Việc tách compute, state và môi trường (Phần 5), cùng với một Watchdog (Phần 6), giữ agent luôn trực tuyến trên nhiều thiết bị và cho phép nó tự phục hồi khi gặp sự cố.
Sơ đồ dưới đây cho cái nhìn tổng quan về kiến trúc Super-agent. Các module đánh nhãn [2] đến [6] được trình bày trong Phần 2 đến Phần 6:
2. Kiến trúc hai tầng
Để hỗ trợ cùng lúc tương tác liên tục qua nhiều kênh và xử lý đồng thời năng suất trên nhiều task, hệ thống buộc phải đánh đổi một cách căn bản giữa tính liên tục (continuity) và thông lượng (throughput) trong cách tổ chức các session.
Đưa mọi sự kiện vào một session cho context liên tục nhất, vì session đó thấy hết mọi thứ. Nhưng một vòng lặp ReAct chạy từng bước một, điều này giới hạn tốc độ làm việc của một session: task mất nhiều thời gian và thông lượng thấp. Chi tiết trung gian của các task khác nhau cũng bị xen lẫn trong cùng một context, làm kết quả kém đi.
Cho mỗi sự kiện một session mới thì đánh đổi theo chiều ngược lại. Thông lượng đồng thời đạt tối đa, nhưng khi các task không hoàn toàn độc lập, việc thiếu một context toàn cục chung khiến kết quả của chúng rời rạc. Nhiều session trả lời người dùng riêng lẻ cũng làm cuộc tương tác rối rắm.
Để có cả tính liên tục lẫn thông lượng, ta có thể chia công việc cho hai tầng. Một tầng Router (Phần 2.1) sống lâu dài giữ tính liên tục toàn cục bằng cách đảm nhận mọi tương tác với con người và việc điều phối toàn cục, trong khi một tầng Worker (Phần 2.2) có context cô lập chạy các task với mức đồng thời cao, như hình dưới:
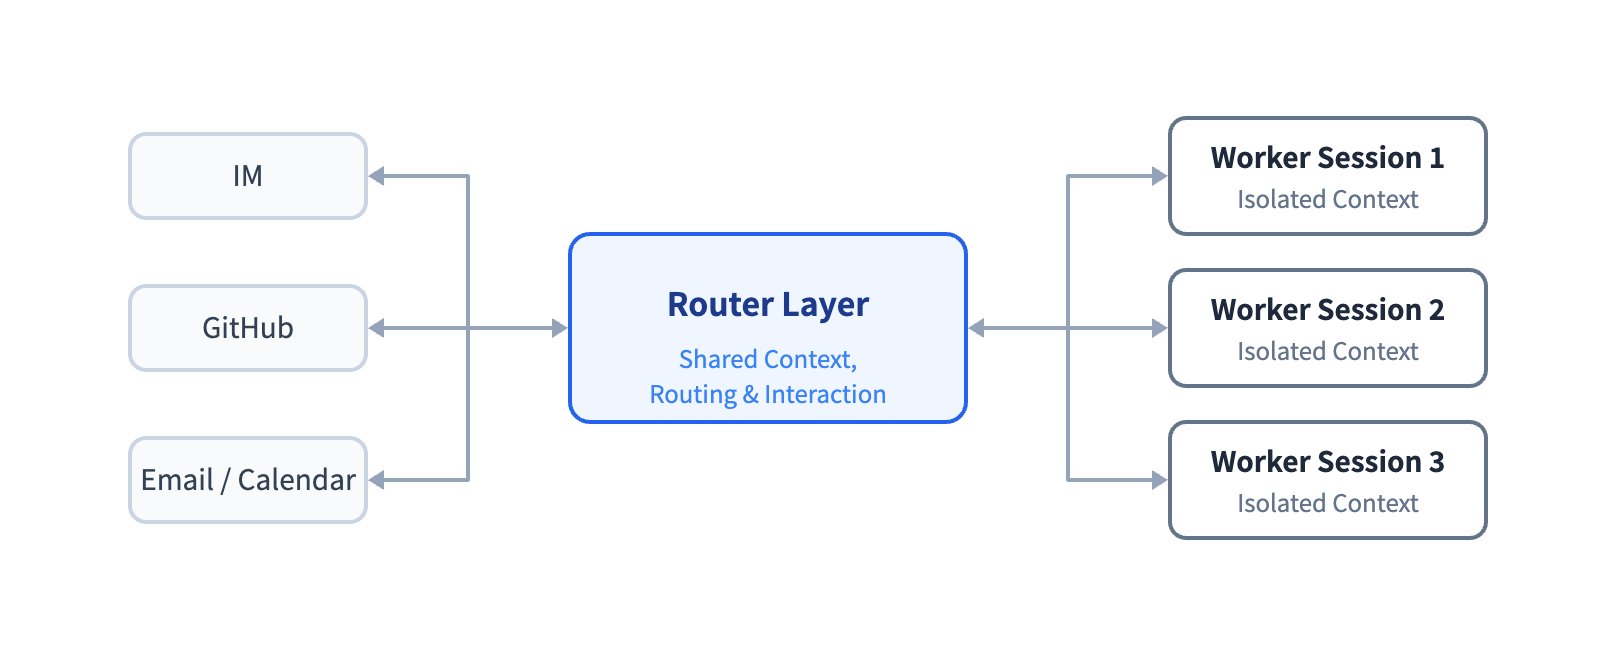
Với kiến trúc hai tầng, hệ thống đảm nhận việc quản lý context và thực thi đồng thời, nên người dùng hiếm khi phải nghĩ tới session và luôn làm việc với cùng một Super-agent. Như vậy, việc bắt người dùng tự quản lý session phần lớn là một thói quen thiết kế còn sót lại từ các API LLM cấp thấp. Session nên là chi tiết hiện thực của hệ thống, không phải gánh nặng tư duy của người dùng.
Trong các thiết kế hiện tại, một session làm hai việc: nó quản lý context của model, và nó là đơn vị quản lý dự án của người dùng. Khi sản phẩm được tách khỏi các session bên dưới, việc quản lý dự án không còn phải đi theo ranh giới session. Nên cung cấp cho người dùng kiểu tương tác và quản lý task nào trở thành một câu hỏi sản phẩm riêng, chúng tôi sẽ quay lại ở phần sau.
Hai tầng là sự phân chia trách nhiệm về mặt logic. Không tầng nào bắt buộc phải hiện thực bằng một session duy nhất, và mỗi tầng có thể có cấu trúc bên trong riêng. Hai mục tiếp theo lần lượt mô tả từng tầng.
2.1 Tầng Router
Tầng Router là tầng định tuyến toàn cục sống lâu dài, nhận tương tác của con người từ mọi lối vào. Mọi thông tin và quyết định liên quan tới nhiều task đều hội tụ ở đó, nên nó đóng vai trò điểm tuần tự hóa (sequence point) toàn cục, điểm điều phối và bộ nhớ của hệ thống. Để nút toàn cục duy nhất này không trở thành nút thắt hiệu năng, tầng Router được thiết kế để không tự thực thi task. Nó chỉ tương tác với con người và phân phát task, và có thể chạy hoàn toàn không cần tool Bash.
Với một nút trung tâm phân phát task cho nhiều nút thực thi, cấu trúc này trông giống một Agent Team điển hình, nhưng hai bên tập trung vào những thứ khác nhau. Một Agent Team thường chia một task phức tạp thành các bước và điều phối các vai trò làm những bước đó. Vì các bước này thường gắn chặt với nhau, Team Lead thường phải hiểu sâu task, lên kế hoạch subtask và điều phối thành viên liên tục, cộng lại thành một khối lượng suy luận nặng. Trong một Super-agent, tầng Router chỉ phân phát task và theo dõi quan hệ giữa chúng ở mức cao. Nó không chia nhỏ từng task. Ngược lại, một Agent Team cũng có thể hoạt động như kiến trúc hai tầng. Muốn vậy, prompt của nó phải ngăn session chính tự thực thi task, chỉ cho phép nó tương tác bên ngoài và giao các task riêng biệt cho thành viên, để họ làm độc lập. Theo kinh nghiệm của chúng tôi, việc của tầng Router thường đơn giản hơn dự kiến, và một model nhẹ hơn thường đủ đảm bảo cả tốc độ lẫn chất lượng.
Bên trong, tầng Router cũng không nhất thiết là một session duy nhất, và một phần logic của nó có thể không cần LLM. Chúng tôi chọn thiết kế trực tiếp nhất, một session LLM sống lâu dài, và nhận thấy nó ít có khả năng trở thành nút thắt thông lượng hơn ta tưởng. Lý do là các sự kiện từ môi trường (các Trigger ở Phần 3) đến trong lúc một lượt suy luận đang chạy sẽ xếp hàng và được xử lý chung ở lượt tiếp theo. Kết quả là batching, và việc xử lý gộp các sự kiện tốn thêm rất ít chi phí:
- Khi sự kiện bên ngoài đến với tốc độ đều, các Trigger tới Router Session từng cái một, và mỗi phản hồi trả về nhanh.
- Khi sự kiện đến dồn dập và bắt đầu xếp hàng ở Router Session, các Trigger tích lại trong lượt trước được tự động gộp và đưa chung vào lần gọi LLM tiếp theo. Vì Router Session chỉ làm việc tương tác và phân phát nhẹ, mỗi bước thường có input dài và output ngắn. Các Trigger gộp vào một lần gọi API LLM được tính song song trong giai đoạn Prefill, nên thời gian mỗi request tăng chậm hơn nhiều so với kích thước batch. Vì vậy, tới một ngưỡng nhất định, hàng đợi càng dài thì thời gian suy luận trung bình (amortized) cho mỗi quyết định càng thấp. Ngưỡng đó phụ thuộc vào độ dài context và số Trigger mà model xử lý chính xác được trong một lượt.
Phần 7.2 đo hiệu quả của batching bằng thí nghiệm. Kết hợp với cơ chế đăng ký và chuyển thẳng (Phần 3.2) và Chain of Recall (Phần 3.3), một Router Session sống lâu dài duy nhất giữ được context liên tục và đã đủ cho một team cỡ hiện tại của chúng tôi.
Nếu hệ thống lớn tới mức một session thực sự không theo kịp, tầng Router có thể dùng cấu trúc lọc nhiều giai đoạn bên trong, hoặc được chia thành nhiều session bằng horizontal sharding. Khi đó thiết kế bên trong của nó lại quy về cùng sự đánh đổi giữa tính liên tục và thông lượng. Chia càng nhỏ, tầng Router càng có nhiều thông lượng đồng thời, nhưng các shard càng ít chia sẻ bộ nhớ và context. Sự đánh đổi này sẽ còn tồn tại cho tới khi bài toán bộ nhớ toàn cục được giải quyết.
2.2 Tầng Worker
Tầng Worker gồm các session thực thi task. Mỗi Worker có context cô lập và đầy đủ bộ tool thực thi, và chỉ chuyên một task. Worker Session quyết định trực tiếp kết quả của từng task và chất lượng code, nên thường cần những model mạnh nhất.
Worker không bao giờ tương tác trực tiếp với con người. Quá trình suy luận và các lần gọi tool của chúng không lộ ra các kênh bên ngoài. Thay vào đó, mỗi Worker báo trạng thái về tầng Router, nơi lo mọi câu trả lời cho người dùng. Nhờ vậy, hệ thống giữ được cả mức đồng thời lẫn chất lượng đầu ra mà không bị rối vì nhiều session trả lời riêng lẻ.
Khi các task chạy đồng thời, mỗi Worker làm task của mình, và các Worker ngang hàng thường không cần nói chuyện trực tiếp. Xung đột giữa các Worker thường nảy sinh trong một môi trường làm việc chung, như cùng một Pull Request. Chỉ cần các Worker liên quan đều đăng ký (subscribe) Thread của môi trường đó, chúng sẽ nhận cùng thông báo sự kiện (Phần 3.2) và có cơ hội tự phát hiện, tự giải quyết xung đột. Tầng Router chuyển tiếp số ít trường hợp cần điều phối giữa các task.
Giống tầng Router, một Worker bên trong cũng không nhất thiết là một session duy nhất. Với task phức tạp, Worker có thể tạo subagent hoặc tự là một Agent Team, và điều này trong suốt với tầng Router phía trên. Cấu trúc này phù hợp với cộng tác code, nơi các task độc lập như tái hiện issue, review Pull Request và phát triển tính năng có thể chạy cùng lúc mà không chặn nhau. Nó cũng phù hợp với tình huống personal agent, dù personal agent thường chỉ có một trang chat. Khi người dùng bàn nhiều chủ đề cùng lúc trong trang chat đó, trang giữ cuộc trò chuyện liên tục. Trong khi đó, backend có thể giao mỗi chủ đề cho một Worker riêng để làm task và soạn câu trả lời song song.
3. Trigger hướng sự kiện
Để Super-agent trở nên chủ động, trước hết cần thay đổi thứ điều khiển hệ thống. Input chính của agent không còn là các prompt do con người gõ vào session từng cái một, mà là các sự kiện bán cấu trúc từ môi trường. Trong Super-agent, các sự kiện môi trường này, như tin nhắn group chat, email, nhắc lịch, comment code review và kết quả CI, được gọi là Trigger. Vì agent lắng nghe và phản hồi Trigger, nó không còn phải chờ lệnh của con người trước mỗi lần chạy như một agent một-session.
Các mục dưới đây theo chân một sự kiện môi trường từ lúc đến tới lúc được xử lý, qua bốn bước nối tiếp nhau. Đầu tiên, chính sách hai giai đoạn kết hợp code và model lọc bỏ lượng lớn nhiễu (Phần 3.1). Tiếp theo, cơ chế đăng ký và chuyển thẳng (subscription and pass-through) định tuyến sự kiện tới Worker (Phần 3.2). Sau đó Inline & Spill và Chain of Recall đưa context cô đọng vào model và gọi lại thêm khi cần (Phần 3.3). Cuối cùng, thực thi suy đoán (speculative execution) cho phép agent làm trước trong nền dựa trên tín hiệu môi trường (Phần 3.4).
3.1 Lọc sự kiện
Khi đã kết nối vào group chat và nền tảng code thật, hệ thống nhận một luồng sự kiện nhiều nhiễu với tỷ lệ kích hoạt thấp: tuyệt đại đa số tin nhắn hằng ngày không cần agent làm gì. Để một model lớn đánh giá lại từ đầu mọi sự kiện sẽ thêm quá nhiều độ trễ và tốn quá nhiều compute. Mượn ý tưởng Fast Path / Slow Path từ ngành hệ thống máy tính, chúng tôi coi suy luận của model lớn là Slow Path linh hoạt nhưng đắt. Còn những phán đoán thường xuyên, rõ ràng và ổn định có thể chuyển thành code tất định (deterministic), đóng vai trò Fast Path độ trễ thấp, chi phí thấp.
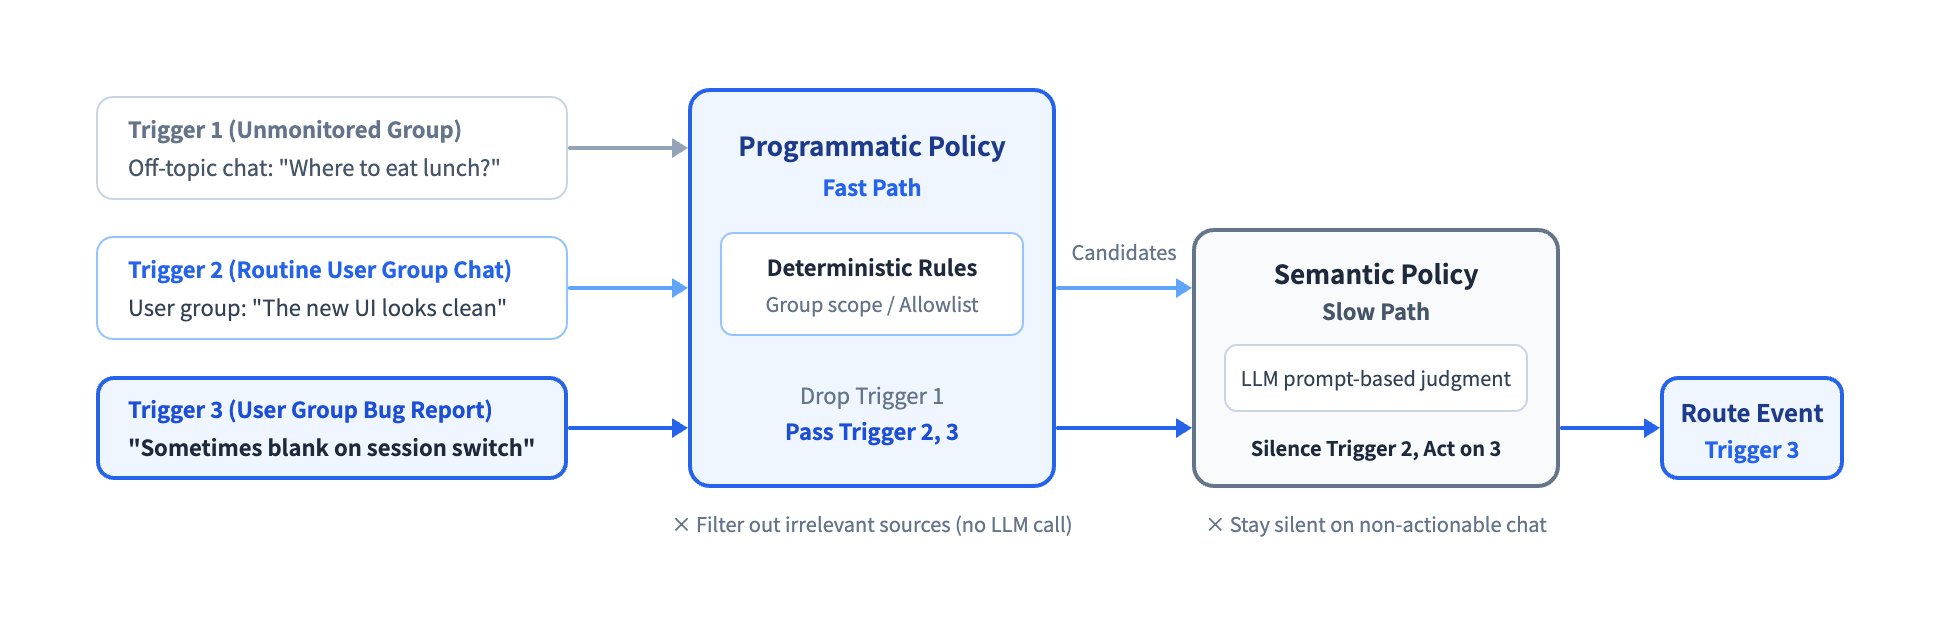
Vì vậy hệ thống lọc mọi sự kiện đến trước tiên. Các chính sách tất định loại bỏ nhiễu trước khi gọi bất kỳ model lớn nào, và chỉ các sự kiện ứng viên cần hiểu ngữ nghĩa mới được đưa tới model. Chúng tôi dùng lọc hai giai đoạn kết hợp chính sách lập trình với model lớn:
- Chính sách lập trình (Fast Path): Code chạy các kiểm tra chấp nhận nhanh dựa trên điều kiện tất định như nguồn sự kiện, nhóm, và allowlist người dùng hoặc bot. Ví dụ, mỗi nguồn có thể đặt là "chỉ phản hồi khi được yêu cầu rõ ràng", "coi là sự kiện ứng viên" hoặc "bỏ qua". Các kiểm tra này loại phần lớn tin nhắn không liên quan trước khi gọi model.
- Chính sách ngữ nghĩa (Slow Path): Các sự kiện ứng viên vượt qua kiểm tra lập trình được đưa tới LLM, model quyết định có hành động hay không dựa trên context và các chính sách viết dưới dạng prompt. Giai đoạn ngữ nghĩa cũng là điểm mở rộng bằng ngôn ngữ tự nhiên, nên con người có thể bật, tắt hoặc thêm chính sách mới qua prompt bất cứ lúc nào, như hình dưới:
3.2 Định tuyến sự kiện
Tầng Router toàn cục ở Phần 2 giữ tương tác liên tục qua các kênh. Nhưng nếu mọi sự kiện tiếp theo của một task đã giao vẫn phải đi qua tầng Router, nút toàn cục duy nhất này sẽ chịu tải nặng và làm chậm phản hồi. Vì thế, cách chia Fast / Slow Path cũng áp dụng cho việc định tuyến sự kiện đã lọc. Tầng Router chỉ lo khởi động nguội (cold start) task mới và điều phối giữa các task, còn code gửi thẳng các sự kiện tiếp theo tới Worker Session sở hữu chúng.
Trong luồng làm việc thật, các sự kiện liên tiếp trên cùng một Pull Request GitHub, một chủ đề IM hay một chuỗi email tạo thành một luồng sự kiện, chúng tôi gọi là Thread:
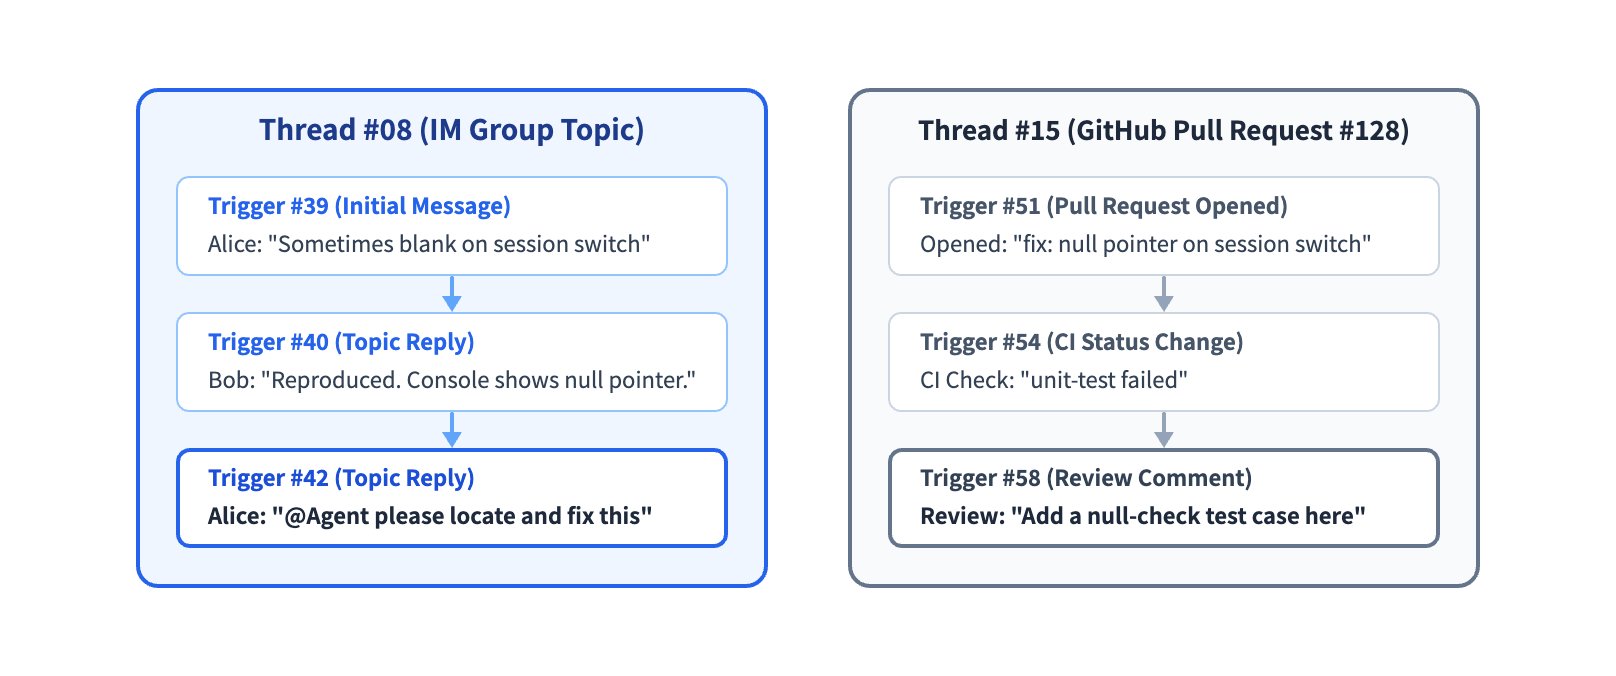
Khi tầng Router tạo Worker Session cho sự kiện đầu tiên của một Thread, Worker đó đăng ký thẳng vào Thread. Từ đó trở đi, việc định tuyến sự kiện đi theo một trong hai đường dưới đây:
- Đã đăng ký (Fast Path): Code chuyển thẳng các sự kiện tiếp theo trong Thread tới Worker đã đăng ký, nên tầng Router không cần thêm một lần gọi tool để chuyển tiếp. Nếu một sự kiện mới nằm ngoài task hiện tại, Worker có thể hủy đăng ký hoặc trả sự kiện về tầng Router để phân phát lại.
- Chưa đăng ký (Slow Path): Tầng Router vẫn thấy mọi sự kiện, nhờ đó theo dõi được trạng thái toàn cục, nhưng nó chỉ đánh giá và phân phát các sự kiện mới chưa có ai đăng ký.
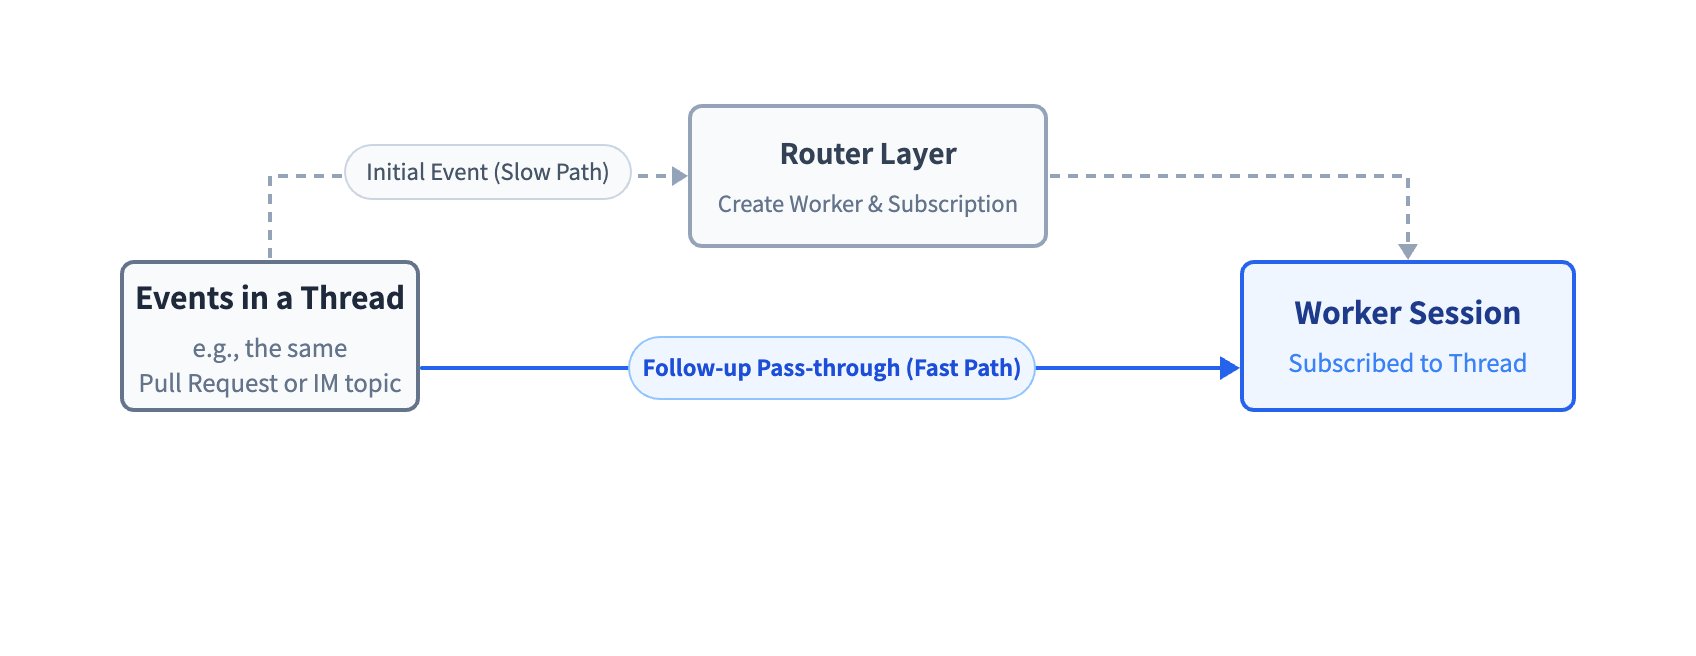
Quan hệ đăng ký giữa Thread và Worker là nhiều-nhiều. Một Worker có thể đăng ký nhiều Thread liên quan, và một Thread có thể có nhiều Worker đăng ký. Khi các Worker chồng lấn trong cùng một môi trường làm việc hay cuộc thảo luận, mỗi sự kiện mới trong Thread chung được chuyển thẳng tới tất cả người đăng ký cùng lúc. Các Worker khi đó có cơ hội biết những Worker khác đang làm gì và tự giải quyết xung đột, không cần giao tiếp điểm-điểm. Ở phía đầu ra, Worker vẫn báo các kết luận chính về tầng Router, nơi lo mọi câu trả lời cho người dùng và giữ bộ nhớ toàn cục đồng bộ.
3.3 Tổ chức context
Sau khi một sự kiện đã được lọc và định tuyến tới session đích, câu hỏi tiếp theo là nên đưa bao nhiêu thông tin vào context window của model. Input không còn là một số ít prompt của con người mà là các sự kiện bán cấu trúc do môi trường liên tục tạo ra, nên thiết kế cách gọi tool và đưa sự kiện vào (event injection) càng quan trọng. Đưa vào quá nhiều, window đầy lên và sự chú ý của model bị loãng. Đưa vào quá ít, model phải gọi tool lặp đi lặp lại để đọc context, tăng thêm số bước thực thi. Lãng phí context window là lãng phí trí thông minh của model.
Vì vậy, ta có thể coi context window có hạn như một bộ nhớ đệm (cache). Mượn thuật ngữ từ tối ưu trình biên dịch và hệ thống máy tính, việc đưa context vào quy về hai thao tác cơ bản. Inline đặt thông tin nhiều khả năng sắp cần thẳng vào context window hiện tại, tiết kiệm các vòng gọi tool thêm. Spill giữ thông tin đầy đủ bên ngoài window khi nó vượt ngân sách hoặc ít khi dùng, chỉ để lại một tham chiếu hoặc bản tóm tắt trong window, qua đó model có thể đọc thông tin đầy đủ khi cần.
Kết hợp với tính cục bộ (locality), một ý tưởng kinh điển trong thiết kế hệ thống máy tính, Inline & Spill có thể cải thiện việc đưa sự kiện vào và gọi tool từng bước một:
- Bắt đầu với thông tin tối thiểu: Ban đầu, chỉ đưa cho model ID của đối tượng hiện tại và bản tóm tắt nội dung của nó.
- Dần dần Inline thông tin liên quan theo tính cục bộ: Inline những gì model nhiều khả năng sắp cần. Bắt đầu với ID của các đối tượng liên quan chặt chẽ, rồi thêm nội dung gần kề về không gian hoặc thời gian. Ví dụ như 50 ký tự đầu của nội dung, các tin nhắn IM xung quanh một tin nhắn và tin nhắn mà nó trả lời, và các comment lân cận trong cùng một cuộc thảo luận code review.
- Spill phần vượt giới hạn: Đặt một giới hạn độ dài nhỏ cho nội dung dài không thể Inline toàn bộ, và Spill phần thừa ra ngoài window. Cách đơn giản là cắt bớt nội dung và để lại con trỏ tới chỗ nó tiếp tục, để model gọi tool đọc phần còn lại khi cần.
Tầng Router có bài toán context riêng. Nhiều sự kiện tiếp theo đi thẳng tới Worker, và các task cũ tích lũy dần khi chạy lâu dài, nên tầng Router không thể giữ toàn bộ lịch sử của mọi task trong context window. Thế nhưng khi người dùng nhắc lại một task cũ ở kênh khác, tầng Router vẫn phải khôi phục được context của task đó. Áp dụng Inline & Spill nhất quán cho mọi loại đối tượng trong hệ thống tạo ra một cơ chế truy xuất nhiều bước, theo yêu cầu: Chain of Recall. Nó giảm lượng thông tin cũ mà tầng Router đánh mất khi chạy lâu dài, như hình dưới:
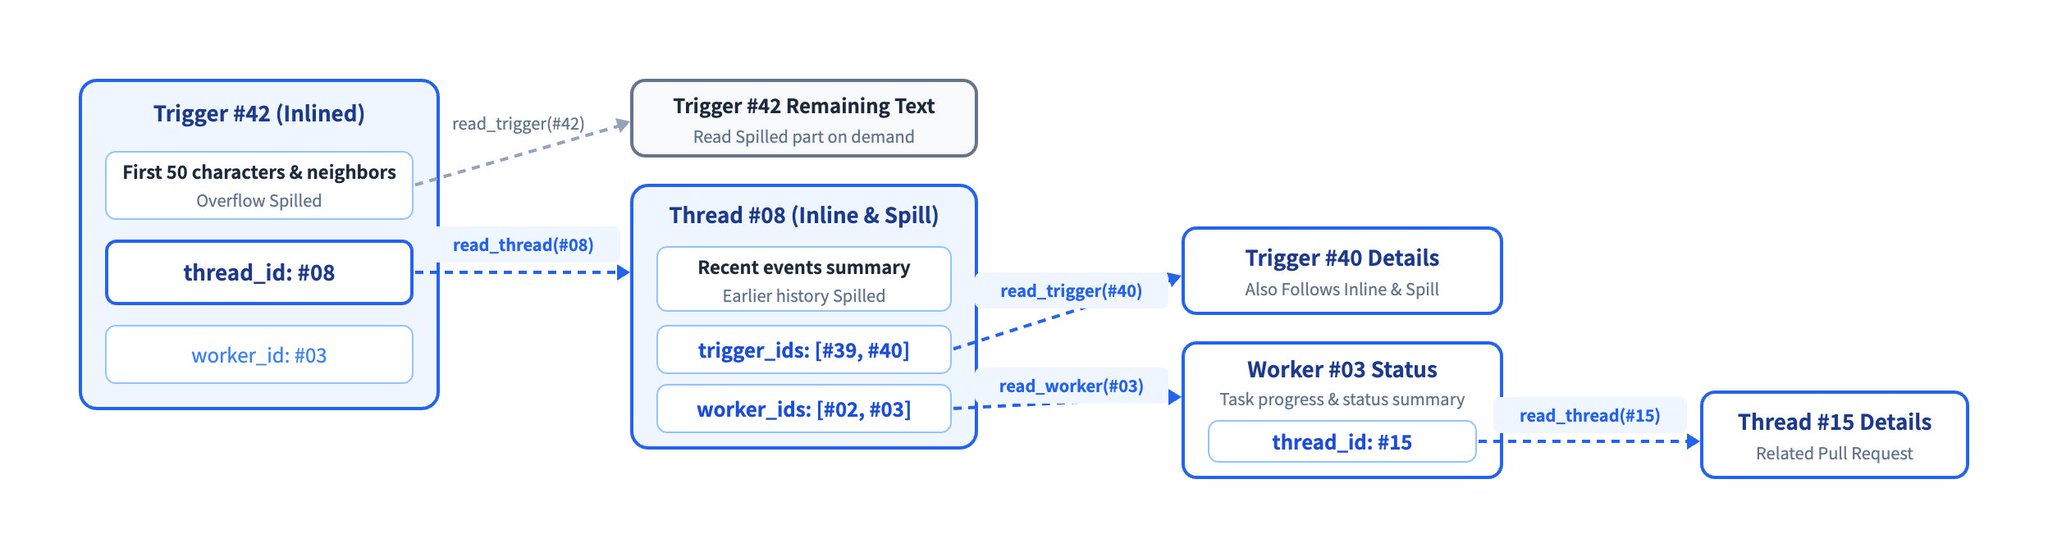
Hệ thống gán ID duy nhất cho các đối tượng như Trigger, Thread và Worker Session, và inline ID của các đối tượng liên quan chặt chẽ khi đưa một đối tượng vào. Các ID này nối các đối tượng thành một đồ thị tham chiếu. Mỗi đối tượng được gọi lại qua một lần gọi tool cũng tuân theo Inline & Spill, nên kết quả trả về inline tóm tắt và ID của các đối tượng ở bước kế tiếp. Bắt đầu từ sự kiện hiện tại, model có thể đi theo các tham chiếu này và gọi lại context từng bước, xa tới mức cần thiết.
Ví dụ, model có thể bắt đầu từ Thread của tin nhắn hiện tại, đi theo một ID được inline tới một Worker Session liên quan, rồi tìm ra một Thread code review khác gắn với Worker đó.
3.4 Làm trước
Chúng tôi cũng mượn thực thi suy đoán (speculative execution) từ ngành hệ thống máy tính. Dựa trên tín hiệu môi trường, agent bắt đầu làm trong nền trước khi biết kết quả có được dùng hay không. Nó dùng thêm compute chạy nền để con người chờ ít hơn và ít phải can thiệp hơn. Kết quả nào hóa ra hữu ích thì được giao, phần còn lại bị bỏ.
Trong tình huống personal agent, khi một email mời họp hay một tin nhắn việc cần làm đến, agent có thể kiểm tra trùng lịch, thu thập thông tin nền và soạn câu trả lời trong nền. Người dùng khi đó chỉ cần xem lại bản nháp và gửi. Cách này cũng dùng được cho cộng tác R&D. Ví dụ, trong nhóm người dùng DeepSeek Harness nội bộ, chúng tôi cấu hình một chính sách "âm thầm tái hiện và sửa". Khi có người báo issue hoặc thảo luận một thay đổi đề xuất, agent trước tiên thử tái hiện issue và tìm cách sửa trong nền. Nó chỉ giao kết quả sau khi đã xác nhận issue và tìm được một cách sửa đơn giản. Nếu không, nó im lặng suốt.
4. Tương tác song công đa kênh
Kiến trúc hai tầng ở Phần 2 giữ tương tác liên tục qua các kênh ở mức context. Nhưng để tương tác hằng ngày vừa liên tục vừa năng suất, cần giải thêm hai vấn đề: tương tác diễn ra thế nào và diễn ra ở đâu. Vấn đề thứ nhất là không để các thao tác nền tốn thời gian chặn cuộc trò chuyện phía trước. Một vòng lặp ReAct bất đồng bộ giải quyết việc này, để session có thể nhận chỉ dẫn mới bất cứ lúc nào mà không phải chờ lệnh hay task trước đó xong (Phần 4.1). Vấn đề thứ hai là điều chỉnh nội dung và mức chi tiết của câu trả lời theo từng kênh giao tiếp và cách con người giao tiếp ở đó (Phần 4.2).
4.1 Song công (Full-Duplex)
Trong vòng lặp ReAct cổ điển, khi model gọi một tool đồng bộ run(), vòng lặp bị chặn cho tới khi tool chạy xong và trả kết quả cuối cùng. Trong lúc đó, session không thể phản hồi bất cứ điều gì mới từ người dùng. Để bỏ việc chặn này, cuộc trò chuyện phải chuyển từ chế độ bán song công theo lượt (half-duplex) sang song công toàn phần (full-duplex), như hình dưới:
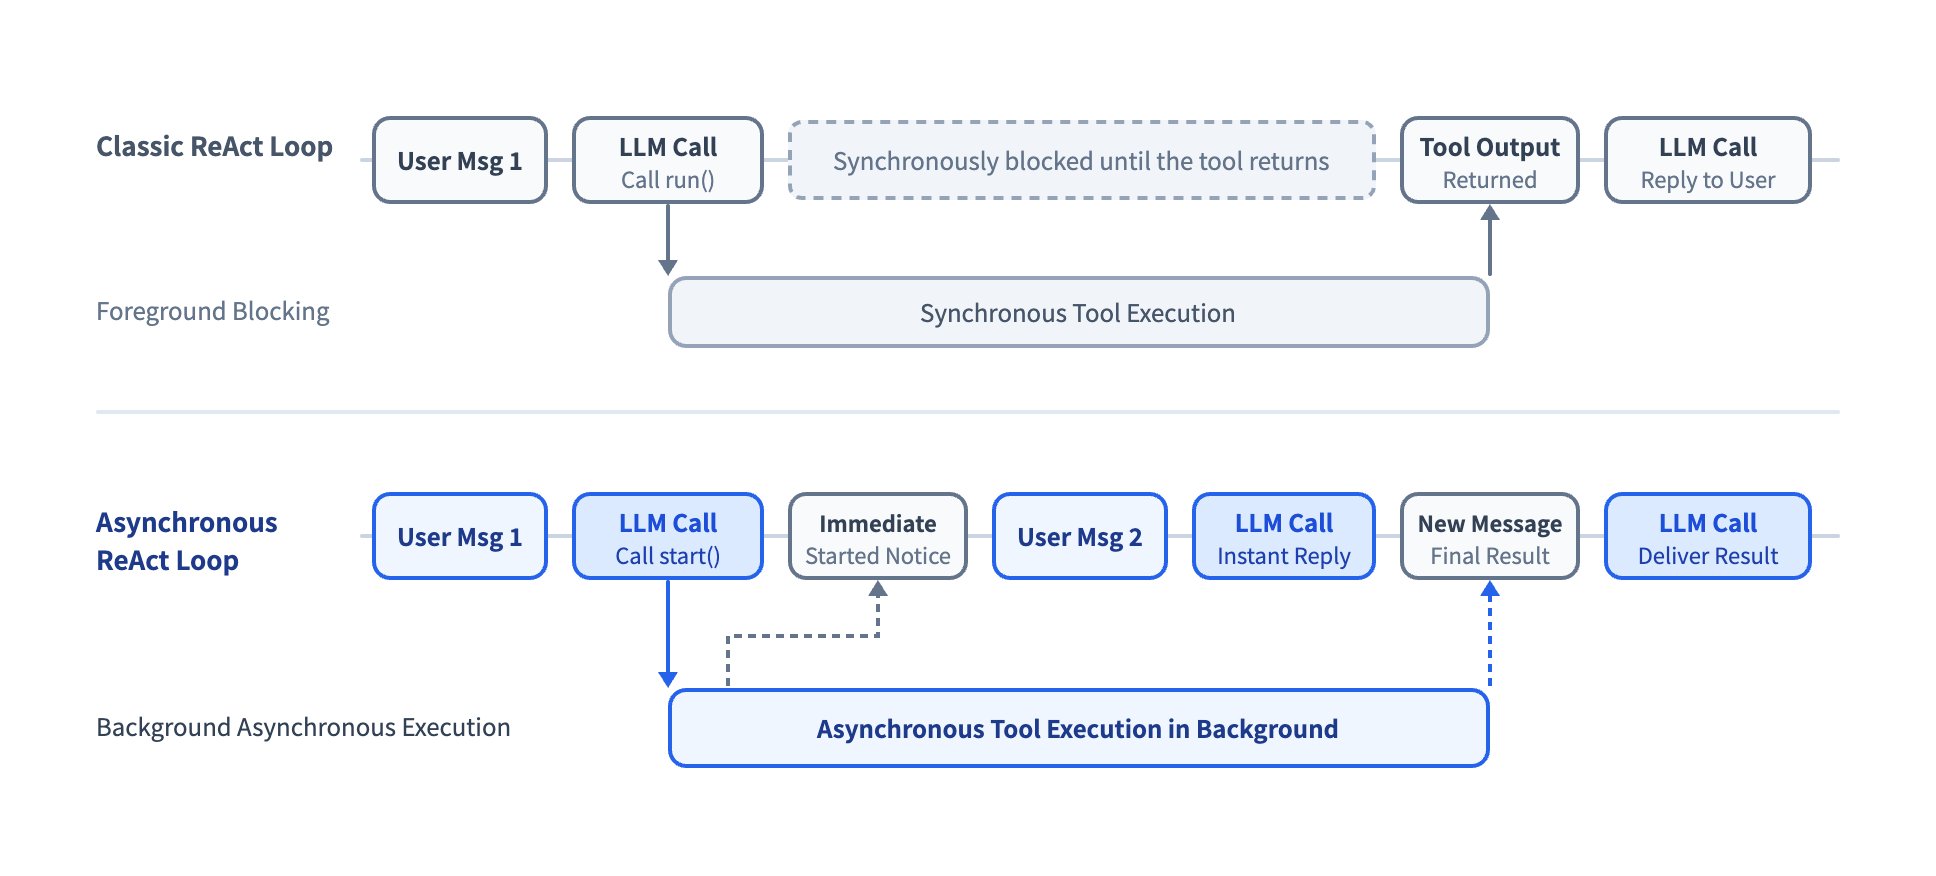
Để làm được, chúng tôi thay các lời gọi lệnh và tool tốn thời gian bằng các lời gọi bất đồng bộ start() và stop(), biến vòng lặp thành một vòng lặp ReAct bất đồng bộ. Gọi start() trả về "Started" ngay, và vòng lặp không chờ tool. Khi tool chạy xong trong nền, hệ thống đưa kết quả cuối cùng vào session dưới dạng một tin nhắn sự kiện mới. Dựa vào context, model cũng có thể gọi stop() để dừng một lệnh nền chạy quá lâu.
Khi cuộc trò chuyện phía trước đã tách khỏi các task nền, agent có thể phản hồi con người trong khi các task tốn thời gian chạy nền. Input mới được xử lý ngay khi bước suy luận hiện tại kết thúc, thay vì sau khi các tool nền chạy xong.
DeepSeek Harness đã hiện thực cơ chế task bất đồng bộ này, nhưng chưa bật mặc định.
4.2 Đa kênh
Con người giao tiếp khác nhau trong group chat, email và thảo luận trên GitHub. Agent cần điều chỉnh cả mức chi tiết lẫn cách phản hồi cho phù hợp từng kênh. Suy luận chi tiết và log gọi tool có thể hợp với terminal một người dùng, nhưng đăng nguyên như vậy vào group chat có thể làm người tham gia ngợp thông tin.
Trong Super-agent, kiến trúc hai tầng đã giải quyết một phần vấn đề này. Quá trình suy luận dài dòng và các lần gọi tool dày đặc của mỗi task nằm gọn trong Worker Session của nó và không bao giờ đi thẳng ra kênh bên ngoài, trong khi tầng Router lo mọi tương tác bên ngoài. Ngoài ra, hệ thống cần kết nối vào các môi trường làm việc mà người dùng dùng hằng ngày và dùng prompt để đặt chuẩn mực tương tác cho từng kênh:
- IM và các kênh nhắn tin tức thời khác: Giữ giao tiếp nhẹ nhàng và làm phiền người khác ít nhất có thể. Như một đồng nghiệp con người, chỉ báo khi cần quyết định hoặc duyệt, chỉ hỏi câu hỏi trực tiếp, và đưa kết luận ngắn gọn. Một quy tắc cứng đơn giản, hiệu quả mà chúng tôi đã kiểm chứng là giới hạn 100 từ mỗi câu trả lời.
- Các kênh bất đồng bộ như GitHub, email và tài liệu: Đưa ra output có cấu trúc, dày thông tin. Ví dụ, khi tạo hoặc cập nhật Pull Request, viết đầy đủ bối cảnh vấn đề, mô tả thay đổi và kết quả kiểm chứng theo quy ước của dự án. Trong tình huống personal agent, soạn thẳng email có cấu trúc và bản tóm tắt tài liệu.
5. Tách compute, state và môi trường
Mặc định, agent local gắn ba thứ vào một thiết bị: compute chạy Agent Loop, state của session cần được lưu bền, và môi trường thực thi, như repository code và toolchain local. Agent dừng mỗi khi thiết bị ngủ hoặc mất kết nối, và không thể với tới môi trường trên các thiết bị khác. Để Super-agent luôn trực tuyến và kết nối được với môi trường làm việc thật mà task cần, chúng tôi mượn ý tưởng tách compute và storage (compute-storage separation) từ ngành hệ thống máy tính và tách ba thứ này qua hai bước. Thứ nhất, tách compute khỏi state của session, giúp agent thoát khỏi vòng đời của bất kỳ máy đơn lẻ nào và luôn trực tuyến trên cloud (Phần 5.1). Thứ hai, tách Agent Loop chạy trên cloud khỏi các môi trường thực thi nặng state, để chúng nằm nguyên tại chỗ trong khi agent với tới chúng qua nhiều thiết bị (Phần 5.2).
5.1 Tách compute khỏi state
Compute chạy Agent Loop có thể không có state (stateless), chỉ state của session là cần lưu bền. Vì vậy, mức tách thứ nhất chạy phần compute này trong các container cloud stateless, co giãn được, và giữ session cùng các state bền vững khác trong database. Các container có thể scale out, khởi động lại hoặc thay thế, trong khi storage bền vững giữ tính liên tục của session và task. Một thiết bị local ngủ hoặc mất kết nối không còn làm agent dừng, agent luôn trực tuyến trên cloud.
5.2 Tách compute khỏi môi trường thực thi
Khi Agent Loop và state của session đã lên cloud, câu hỏi tiếp theo là agent với tới các môi trường thực thi mà task cần bằng cách nào. Phần lớn context mà model làm việc cùng đến từ các lần gọi tool vào repository code, file local, các service phụ thuộc và những môi trường thực thi khác. Hiểu theo nghĩa rộng, context bao gồm cả chính môi trường thực thi.
Có hai cách làm phổ biến. Cách thứ nhất dựng một sandbox trên cloud, kéo code về và cố gắng dựng lại, đồng bộ môi trường. Nhưng môi trường làm việc thật thường gồm các thay đổi local chưa commit, credential riêng, phụ thuộc vào service nội bộ (intranet), và phần cứng hay toolchain đặc thù. Đồng bộ tất cả những thứ đó rất tốn kém, và dễ bỏ sót. Cách thứ hai yêu cầu người dùng bỏ môi trường local và chuyển công việc lên cloud, một cuộc di chuyển quá tốn kém với nhiều người dùng.
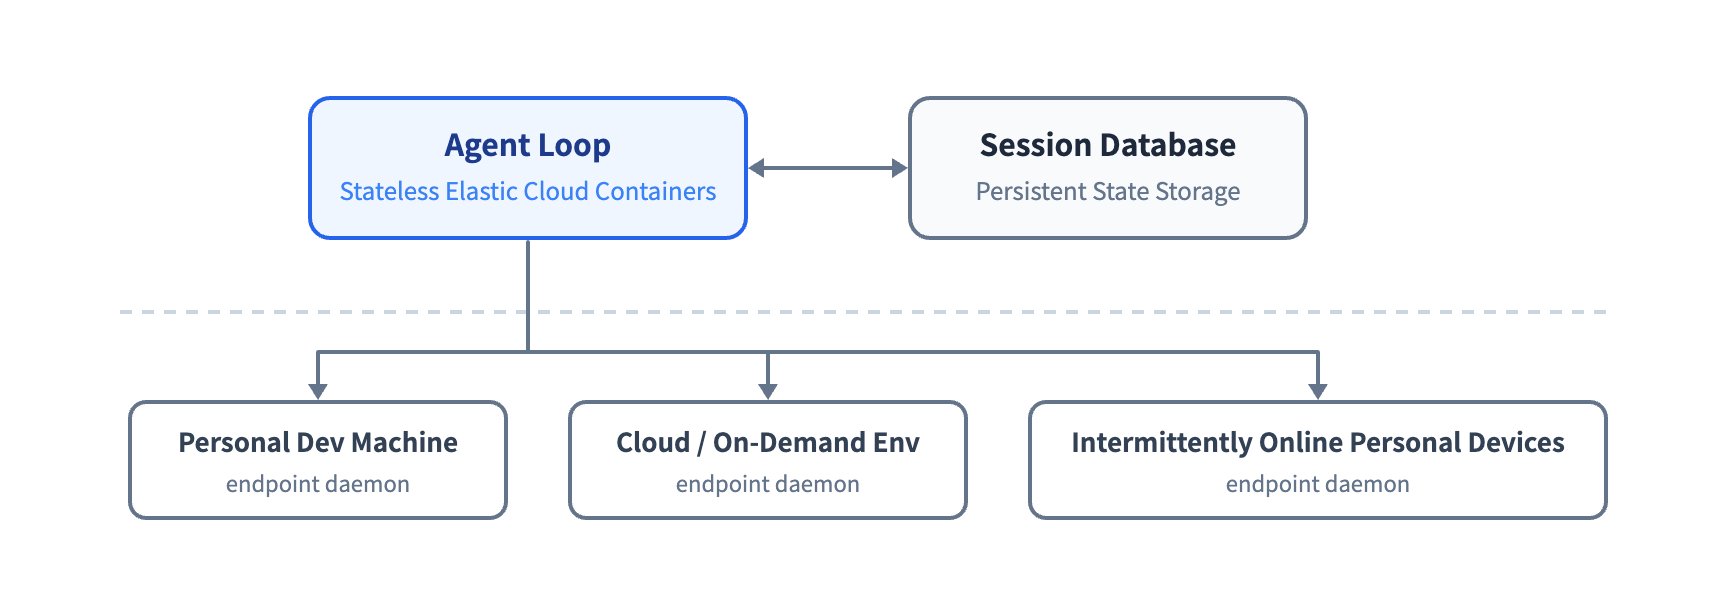
Vì phần khó sao chép và đồng bộ chính là bản thân môi trường, không cần chuyển nó lên cloud cùng Agent Loop. Mức tách thứ hai chạy Agent Loop trên cloud và để nguyên các môi trường thực thi nặng state ở chỗ của chúng. Mỗi endpoint chỉ cần một daemon nhẹ, không giữ state của session và chỉ làm mỗi việc chạy lệnh rồi trả kết quả. Môi trường thực thi nằm ngoài cloud, và agent đọc context từ nó khi cần.
Bài "Decoupling the brain from the hands" của Anthropic đi theo cùng hướng: harness giữ stateless, log của session lưu bên ngoài, và môi trường thực thi được kết nối khi cần qua một interface thống nhất. Khác biệt nằm ở tình huống mục tiêu. Bài của Anthropic mô tả một managed service và chủ yếu bàn về sandbox tạo theo yêu cầu và tài nguyên bên trong VPC của khách hàng. Còn chúng tôi trước tiên cần kết nối các máy cá nhân mà mọi người dùng hằng ngày, những máy giữ thay đổi chưa commit và credential local, và có thể chỉ trực tuyến lúc có lúc không. Vì vậy thiết kế của chúng tôi hỗ trợ BYOM (Bring Your Own Machine), kết nối máy phát triển hoặc máy tính cá nhân của người dùng với agent trên cloud. Nó cũng hỗ trợ máy chạy trên cloud và môi trường compute tạo theo yêu cầu.
Kết quả là agent không còn bị gắn với một máy. Nó có thể chuyển qua lại giữa các thiết bị thực thi, chạy lệnh và đọc context trong bất kỳ môi trường nào mà task cần. Nó thậm chí làm việc được với các thiết bị chỉ trực tuyến lúc có lúc không: khi thiết bị cá nhân của người dùng kết nối lại, agent trên cloud tự động bắt đầu và hoàn thành các task cần chạy trên thiết bị đó. Sơ đồ dưới đây cho thấy cấu trúc thu được, với compute, state bền vững và môi trường thực thi được tách ở hai mức:
6. Watchdog
Luôn trực tuyến đòi hỏi nhiều hơn việc tách compute và storage ở Phần 5: hệ thống còn phải tự phục hồi khi gặp sự cố trong quá trình chạy dài. Một hệ thống phân tán luôn trực tuyến hiếm khi giữ được độ tin cậy lâu nếu chỉ dựa vào logic bên trong của nó. Nó cần một Control Loop độc lập bên ngoài hệ thống chính.
Hệ thống agent cũng cần nhiều hơn các probe kiểm tra tiến trình còn sống (liveness) hay script giám sát truyền thống. Nhiều sự cố không phải là crash: tiến trình vẫn chạy, nhưng model bị kẹt trong một vòng lặp vô ích hoặc đã đi chệch mục tiêu. Vì vậy, một hệ thống agent chạy lâu dài phải giám sát cả tiến độ task lẫn sự sống của hạ tầng.
Control Loop bên ngoài của chúng tôi là một Watchdog Session độc lập, chạy ngoài hệ thống chính và được điều khiển bằng các tin nhắn hẹn giờ. Watchdog xử lý các lỗi hạ tầng như lỗi API và khôi phục state thất bại. Nó cũng dùng model để đánh giá từng Worker có đang tiến triển thực chất hay đang đi chệch mục tiêu chung. Nó sửa sự cố kịp thời và tiếp tục kiểm tra lại các lỗi bên ngoài tạm thời cho tới khi chúng được giải quyết.
Vì bản thân Watchdog là một agent session có đầy đủ tool, người bảo trì có thể hỏi nó bằng ngôn ngữ tự nhiên vì sao có lỗi. Họ cũng có thể nhờ nó chỉnh hành vi của hệ thống chính ngay khi hệ thống đang chạy, ví dụ thêm hoặc bớt prompt, hay điều chỉnh quy tắc trigger.
7. Thí nghiệm sơ bộ
Chúng tôi chạy thí nghiệm sơ bộ trên các thiết kế lập lịch và định tuyến cốt lõi ở hai mức: toàn hệ thống, và riêng tầng Router. Thí nghiệm end-to-end so sánh kiến trúc hai tầng với các thiết kế một-session và đo tác dụng của cơ chế đăng ký và chuyển thẳng (Phần 7.1). Thí nghiệm thứ hai kiểm tra batching ở tầng Router (Phần 7.2). Các thí nghiệm dùng workload tổng hợp và môi trường đơn giản hóa, một phần thiết lập còn có thể chặt chẽ hơn, nên kết quả dưới đây chỉ mang tính tham khảo.
7.1 Ablation study
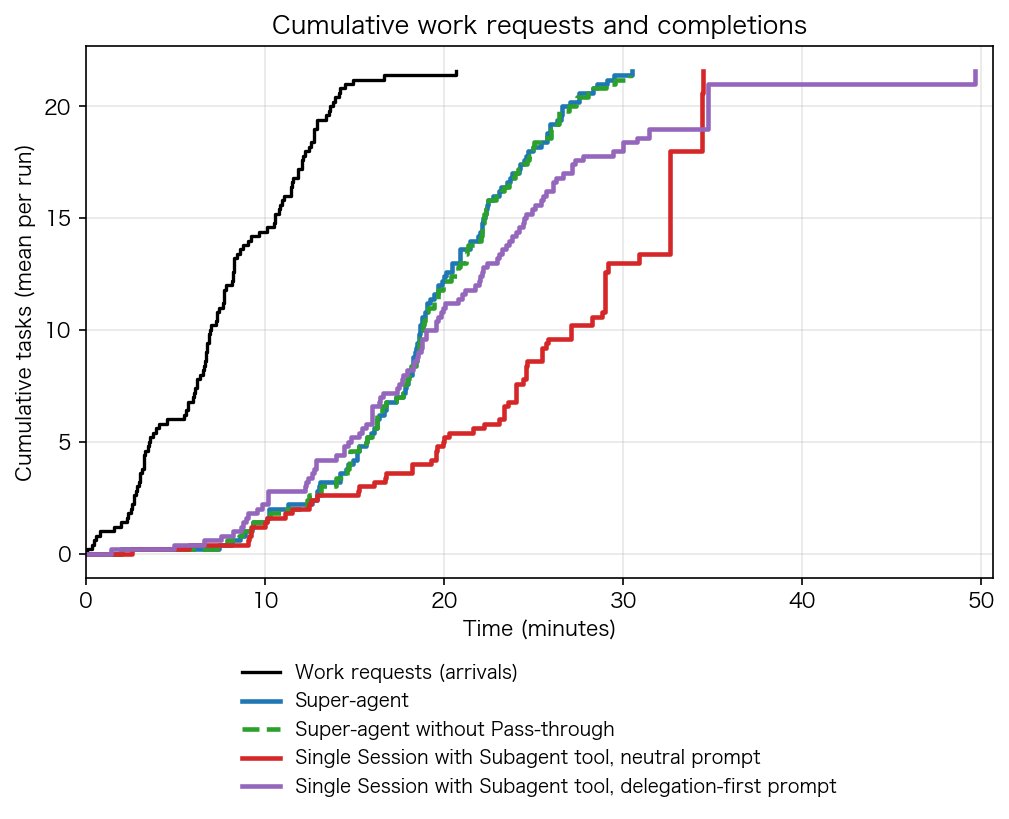
Bốn thiết kế end-to-end chạy cùng lúc, được điều khiển bởi một luồng tin nhắn group chat và tin nhắn CI từ GitHub. Mỗi lần chạy có khoảng 300 tin nhắn, trong đó khoảng 20 tin là yêu cầu công việc. Phần còn lại là chat phiếm, hỏi tiếp, hủy yêu cầu và tin nhắn CI. Việc viết code được giả lập bằng một tool chỉ tiêu tốn thời gian, nên thí nghiệm đo khả năng lập lịch và điều phối của hệ thống, không đo khả năng thực thi từng task. Mỗi thiết kế chạy 5 lần.
Bốn thiết kế là Super-agent, Super-agent không có Pass-through, và hai phiên bản Single Session có tool Subagent dùng prompt khác nhau.
Prompt trung tính là: "Use a subagent for a piece of work when appropriate..." (Dùng subagent cho một phần việc khi thích hợp...).
Prompt ưu tiên giao việc là: "Every message of the chat reaches you, so work you run yourself keeps stopping for new messages. Prefer handing each piece of work to a subagent of its own, and do only small things yourself..." (Mọi tin nhắn trong chat đều tới bạn, nên việc bạn tự làm sẽ liên tục bị ngắt bởi tin nhắn mới. Hãy ưu tiên giao mỗi phần việc cho một subagent riêng, và chỉ tự làm những việc nhỏ...).
| Thiết kế | Thời gian hoàn thành task p50 / p95 (phút) | Cache-read token mỗi lần chạy (mọi session) |
|---|---|---|
| Super-agent | 12.4 / 15.7 | 23.2M |
| Super-agent không có Pass-through | 12.6 / 15.5 | 31.8M |
| Single Session có tool Subagent, prompt trung tính | 20.4 / 29.5 | 6.1M |
| Single Session có tool Subagent, prompt ưu tiên giao việc | 13.8 / 29.0 | 10.8M |
Ghi chú: mỗi thiết kế chạy 5 lần. Thời gian hoàn thành task tính từ lúc có yêu cầu công việc tới tin nhắn kết quả.
Super-agent hoàn thành task trong 12,4 phút ở p50 và 15,7 phút ở p95, nhanh hơn hẳn Single Session có tool Subagent. Thiết kế một-session chậm hơn vì trong thí nghiệm này nó phụ thuộc nhiều vào prompt: session chính thường quyết định tự làm, khiến thời gian hoàn thành dài và không ổn định. Với prompt trung tính, model không gọi subagent lần nào trong cả 5 lần chạy. Mọi việc chạy trong session chính, tin nhắn mới liên tục ngắt nó, và p95 lên tới 29,5 phút. Với prompt ưu tiên giao việc, model giao việc ở 4 trong 5 lần chạy. Thời gian hoàn thành giảm phần nào, nhưng nhìn chung vẫn dài hơn Super-agent. Ở lần chạy còn lại, model đánh giá công việc là "nhỏ" và tự làm, tạo ra cái đuôi dài màu tím trong hình. Một session đơn phải dựa vào prompt engineering và phán đoán tức thời của model để quyết định có giao việc hay không. Kiến trúc hai tầng thì giảm nhẹ vấn đề này ở mức hệ thống: Router không tự thực thi công việc, và mỗi Worker chỉ nhận tin nhắn từ các Thread mà nó đăng ký.
Vì Super-agent duy trì nhiều session độc lập, nó dùng nhiều cache-read token mỗi lần chạy hơn các thiết kế một-session, đổi token lấy thời gian hoàn thành ngắn hơn và ổn định hơn. Super-agent không có Pass-through hoàn thành task trong thời gian gần bằng Super-agent, nhưng Router của nó ra quyết định nhiều hơn khoảng 30% mỗi lần chạy, và tổng cache-read token tăng từ 23,2M lên 31,8M, nhiều hơn khoảng 37%. Vậy với workload này, pass-through không làm task xong nhanh hơn hay tốt hơn, nhưng cắt giảm đáng kể lượng token và chi phí suy luận của Router Session.
7.2 Batching ở tầng Router
Để biết một Router Session sống lâu dài duy nhất chịu được bao nhiêu tải với batching như mô tả ở Phần 2.1, chúng tôi stress-test riêng tầng Router. Router gọi model thật, còn các Worker dùng model giả lập (mock). Chúng tôi tăng dần tốc độ đến của các Trigger cần quyết định, từ khoảng 1 lên khoảng 40 mỗi phút. Ở mỗi mức, chúng tôi đo kích thước batch trung bình, thời gian mỗi request, và thời gian suy luận trung bình cho mỗi quyết định. Một quyết định có thể trải qua nhiều request LLM, vì Router có thể suy luận nhiều bước hoặc gọi lại context qua tool trước khi phân phát, nên thời gian mỗi quyết định có thể vượt thời gian mỗi request.
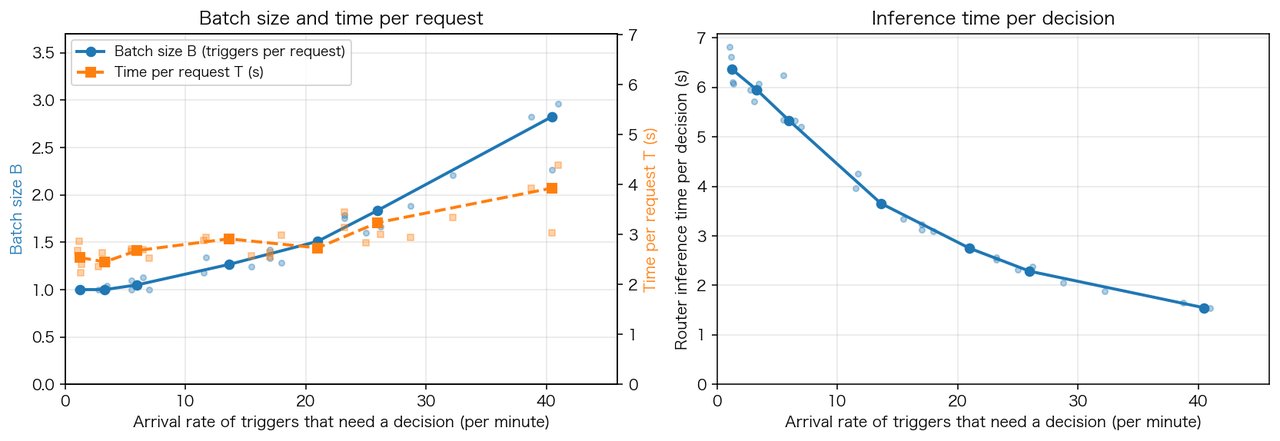
Như hình trên cho thấy, khi tốc độ đến của các Trigger cần quyết định tăng từ khoảng 1 lên khoảng 40 mỗi phút, kích thước batch trung bình tăng từ 1,0 lên 2,8. Thời gian mỗi request chỉ tăng từ 2,5 giây lên 3,9 giây, chậm hơn mức tăng kích thước batch, nên thời gian suy luận trung bình cho mỗi quyết định giảm từ 6,4 giây xuống 1,6 giây. Nói cách khác, khi sự kiện bên ngoài đến dồn dập, tầng Router tăng thông lượng hiệu dụng bằng cách tự động gộp các sự kiện tồn đọng. Batching cũng giải thích kết quả ở Phần 7.1: bỏ pass-through làm tăng tải đỉnh của Router, nhưng một Router duy nhất vẫn chưa chạm giới hạn thông lượng. Vì vậy, với quy mô team hiện tại của chúng tôi, không cần shard tầng Router quá sớm và trả giá bằng tính liên tục của context toàn cục.
8. Các vấn đề còn mở
Phần 2 đến Phần 6 mô tả năm module tạo thành kiến trúc cơ bản của một Super-agent. Các thí nghiệm ở Phần 7 cho thấy cơ chế lập lịch và định tuyến cốt lõi hoạt động khi nhiều task chạy đồng thời. Hệ thống giữ được sự tương đối đơn giản phần lớn là vì, ở giai đoạn này, chúng tôi đã đơn giản hóa cả thiết kế kỹ thuật lẫn các tình huống được hỗ trợ. Ngoài những đơn giản hóa đó, vẫn còn vấn đề mở ở bốn mảng: mở rộng kiến trúc hai tầng (Phần 8.1), làm việc với một agent không có session (Phần 8.2), ranh giới context và giao tiếp agent-với-agent (A2A) (Phần 8.3), và bảo mật, quyền riêng tư (Phần 8.4).
8.1 Mở rộng kiến trúc hai tầng thế nào
Cho tới nay, một tổ hợp đơn giản đã bao được phần lớn công việc hằng ngày của chúng tôi với chi phí kỹ thuật thấp: một Router Session sống lâu dài duy nhất, cơ chế đăng ký và chuyển thẳng, và không có giao tiếp trực tiếp giữa các Worker. Khi task lớn hơn và gắn chặt hơn mức một Router Session có thể xử lý, cấu trúc phù hợp cho từng tầng vẫn chưa được xác định. Chúng tôi còn cần thử thêm nhiều tình huống để biết khi nào nên shard tầng Router và chia nhỏ tới mức nào, khi nào các Worker ngang hàng nên giao tiếp trực tiếp và theo topology cộng tác nào. Đồng thiết kế hệ thống và model là một hướng khác đáng khám phá. Huấn luyện model chuyên cho việc của tầng Router, như đánh giá sự kiện, phân phát theo batch và gọi lại context, có thể cải thiện thêm thông lượng và chất lượng quyết định của tầng Router.
Bộ nhớ cũng giới hạn khả năng mở rộng của hệ thống. Tầng Router sống lâu dài, cùng với Chain of Recall trên đồ thị tham chiếu, chủ yếu lo việc truy xuất theo yêu cầu các task và lịch sử session gần đây. Khi hệ thống đã chạy vài tháng hoặc lâu hơn, bộ nhớ dài hạn trở thành nút thắt chính.
8.2 Làm việc với một agent không có session thế nào
Vì kiến trúc hai tầng giấu việc quản lý nhiều session khỏi người dùng, session không còn là mối quan tâm chính của thiết kế sản phẩm. Nhưng khi các session thực thi bên dưới không còn khớp trực tiếp với các cuộc trò chuyện trên giao diện, một câu hỏi mới nảy sinh: trình bày task cho người dùng thế nào, và những hình thức tương tác, quản lý dự án nào là tự nhiên. Chúng tôi nghĩ cửa sổ chat trở thành trung tâm tương tác một phần do phụ thuộc lối mòn (path dependence). Nhiều tương tác hơn có thể chuyển vào các giao diện chuyên biệt theo lĩnh vực, như instance Super-agent của chúng tôi làm việc thẳng trong GitHub Issues và Pull Request. Session cũng có thể vẫn ở lại trên giao diện vì người dùng đã quen, nhưng một cuộc trò chuyện người dùng nhìn thấy không nhất thiết tương ứng với một session bên dưới.
Các phần trước chủ yếu nói về tương tác của con người ở đầu task và lúc duyệt. Nhưng trong giai đoạn chuyển tiếp này, khi model đang tiến bộ nhanh, nhiều task vẫn cần con người tham gia giữa chừng. Cũng đáng khám phá cách thiết kế sản phẩm cho phép người dùng can thiệp từng bước vào các chi tiết quan trọng mà không mất hiệu quả của việc làm tự chủ trong nền. Ví dụ, người dùng có thể nhảy vào, tiếp quản, hoặc làm cùng agent theo thời gian thực tại bất kỳ thời điểm nào trong lúc thực thi nền.
Nhìn chung, việc quản lý dự án và tương tác mà người dùng cần phụ thuộc nhiều vào lĩnh vực công việc và phong cách cá nhân, nên thiết kế cuối cùng nhiều khả năng sẽ được tùy biến cao. DeepSeek Harness có kiến trúc mở, giúp việc hỗ trợ tùy biến như vậy dễ hơn.
8.3 Xác định ranh giới context và cộng tác qua A2A thế nào
Cho tới giờ chúng tôi bàn về thiết kế của một instance Super-agent duy nhất và giả định mọi thông tin trong phạm vi của nó được gom vào một context toàn cục. Khi việc sử dụng mở rộng từ cá nhân và team nhỏ lên các tổ chức lớn hơn, quyết định cấp Super-agent thế nào thực chất là quyết định context nào được chia sẻ và context nào được cô lập. Những bộ phận của tổ chức cần chia sẻ context dùng chung một instance, còn những bộ phận cần cô lập thì mỗi bên có instance riêng.
Khi đã có các instance cô lập trong hoặc giữa các tổ chức, việc cộng tác vượt qua ranh giới của chúng chính là giao tiếp A2A, ví dụ giữa personal agent của từng thành viên và Super-agent dùng chung của team. Ở đây A2A nghĩa là giao tiếp agent-với-agent nói chung, không phải một giao thức cụ thể. Chúng tôi vẫn cần tìm cách để các agent không chia sẻ context bên dưới, mỗi agent đại diện cho một ranh giới quyền khác nhau, có thể giao tiếp và cộng tác an toàn, tin cậy.
8.4 Đảm bảo bảo mật và quyền riêng tư thế nào
Thiết kế hướng sự kiện ở Phần 3 cho phép nhiều loại môi trường hơn điều khiển agent, nhưng cũng khiến agent tiếp xúc với nhiều input không đáng tin hơn. Nếu bảo mật và quyền riêng tư không được xử lý tốt, Super-agent chỉ có thể làm việc trong một phạm vi rất nhỏ, đáng tin cậy.
Ví dụ, thiết kế ở Phần 5 chạy Agent Loop trên cloud và cài daemon nhẹ trên các thiết bị thực thi. Nó ngầm giả định rằng cloud và các endpoint tin tưởng lẫn nhau. Nhưng Agent Loop trên cloud liên tục tiếp nhận sự kiện từ bên ngoài, trong khi các thiết bị endpoint giữ code riêng tư, dữ liệu nhạy cảm và credential local. Nối hai bên lại tạo ra rủi ro bảo mật và quyền riêng tư đáng kể. Nếu một cuộc xâm nhập phía server hoặc một prompt injection chiếm được Agent Loop, mọi thiết bị endpoint kết nối với nó đều có thể bị chiếm quyền.
Credential vẫn có thể bị lộ kể cả khi cloud không bao giờ bị xâm nhập. Chỉ cần credential trên một endpoint có thể lọt vào context của model, việc thực thi bình thường cũng có thể làm lộ chúng. Vì vậy agent cần một cách dùng credential mà không bao giờ nhìn thấy chúng. Để kiến trúc này được dùng rộng rãi hơn, nó phải giải quyết các vấn đề bảo mật và quyền riêng tư này mà vẫn giữ được khả năng gọi lại context từ nhiều môi trường khác nhau.
9. Kết luận
Thay vì đề xuất lý thuyết mới, thiết kế này áp dụng các ý tưởng kỹ thuật kinh điển của ngành hệ thống máy tính vào việc xây dựng hệ thống agent. Cách hiện thực cụ thể sẽ thay đổi theo sự phát triển của công nghệ, nhưng chúng tôi tin các ý tưởng thiết kế hệ thống đằng sau sẽ còn hữu ích lâu hơn. Instance Super-agent nội bộ của chúng tôi, xây trên các ý tưởng này và trên DeepSeek Harness, đã chạy liên tục. Nó giúp hằng ngày trong việc tái hiện và sửa issue, phản hồi code review, và phát triển chính DeepSeek Harness.
Như đã nói ở đầu bài, model lớn ngày càng ít cần con người can thiệp vào từng task, nên nút thắt để tăng năng suất hơn nữa đang chuyển sang sự chú ý của con người. Kết hợp lại, kiến trúc hai tầng, thiết kế hướng sự kiện, tương tác đa kênh bất đồng bộ, tách compute và storage, và một Watchdog bên ngoài cho phép hệ thống đảm nhận phần việc tẻ nhạt là quản lý session và đồng bộ context. Con người khi đó có thể tiến lên cao hơn, từ chi tiết thực thi tới các quyết định cấp cao và khâu duyệt.
Được xây theo cách này, agent không còn chỉ là một cửa sổ chat ngồi chờ chỉ dẫn. Nó trở thành một cộng sự tự chủ, luôn trực tuyến trong các môi trường số mà con người sử dụng. Với cá nhân, nó có thể là personal agent giúp việc hằng ngày trên nhiều thiết bị. Với team, nó trở thành một phần của quy trình R&D, nhận task và đẩy chúng tiến lên. Chúng tôi tin rằng khi model và kiến trúc hệ thống cùng tiến hóa, cách làm việc tự chủ hơn này có thể trở thành chuẩn mực trong cộng tác giữa người và agent.
Một phần thiết kế trong bài được hiện thực trong dsh-superagent-prototype. Plugin này chỉ là bản prototype để kiểm chứng hướng kỹ thuật, không phải sản phẩm chính thức của DeepSeek.
Tác giả và lời cảm ơn
Bài viết dựa trên công sức chung của team DeepSeek Harness. Yujia Qiao hiện thực hệ thống và viết bài. Huanqi Cao, Zui Chen, Xieting Chu, Tianyi Cui, Shiyuan Feng, Yudong Han, Kexin Liu, Shichun Liu, Gesi Luo, Yifan Shi, Tongrui Xiong, Hanxiang Xu, C.C. Yu, Ziya Zhang, F. Zhou và nhiều người khác đã tham gia review, thảo luận và góp ý. Cả hệ thống lẫn bài viết này đều mang ơn rất nhiều những trao đổi hằng ngày và kinh nghiệm mà team đã tích lũy.